Potenzial von Open Government Data OGD

Von offenen Verwaltungsdaten zum messbaren Mehrwert: Wie Open Government Data KI-Anwendungen und Insights aufwerten können.

Offene Verwaltungsdaten (OGD) haben viel Potenzial für operativen Mehrwert: Sie erweitern interne Datenbestände, unterstützen KI-Agenten und ermöglichen präzisere Insights.

Warum OGD jetzt relevant sind

In einer Zeit, in der immer mehr Unternehmen darauf achten, Entscheidungen auf Basis von Daten zu treffen, werden offene Verwaltungsdaten (Open Government Data, OGD) zunehmend wichtiger. Was als Instrument für die Transparenz des Staates begann, hat sich zu einer Ressource für die Wirtschaft entwickelt. Für datenorientierte Organisationen entsteht durch solche Daten ein operativer Mehrwert: verlässliche, dokumentierte und standardisierte Daten, die interne und spezifisch erhobene Datenbestände erweitern und ergänzen. Dazu stellen Bund, Kantone und Gemeinden Daten interoperabel bereit. Dies reduziert den Aufwand für Bereinigung, Aufbereitung und Integration erheblich und schafft einen stetig wachsenden Fundus an Daten, die für datenbasierte Insights und Services genutzt werden können.

Was sind OGD?

Open Government Data (OGD) sind Verwaltungsdaten, die nach den FAIR-Prinzipien auffindbar, frei zugänglich, maschinenlesbar und vor allem auch ohne Nutzungseinschränkungen bereitgestellt werden. Sie stammen aus klar definierten Erhebungsprozessen, werden entsprechend dokumentiert und ihre Metadaten sind standardisiert. Dies gewährleistet hohe Reproduzierbarkeit und Nachvollziehbarkeit.

Wo finden sich OGD?

Auf der zentralen Publikationsplattform des Bundes (opendata.swiss) werden OGD-Daten aus Bund, Kantonen, Gemeinden und weiteren öffentlich beauftragten Organisationen zusammengeführt. Das Spektrum des Angebots reicht von Gemeindegrenzen, Bevölkerungs- und Wirtschaftsstatistiken über Verkehrs-, Umwelt- und Energiedaten bis hin zu Wetter- und Gesundheitsinformationen. Für die Nutzung durch Unternehmen entsteht damit ein einheitlicher Zugangspunkt zu einem thematisch vielfältigen Datenangebot.

Damit die OGD technisch und semantisch integrierbar sind, kommen einheitliche Metadaten-Standards zum Einsatz. Zentral ist hier DCAT-CH, das Schweizer Profil des europäischen Metadatenstandards DCAT. Der Standard definiert, wie Datensätze beschrieben werden – etwa mit Angaben zu Herausgeber, Thema, räumlicher Gültigkeit, Aktualität oder Lizenz. So können OGD leichter gesucht, verglichen und eingebunden werden

Ein wachsendes Angebot steht zur Verfügung

Ein Blick auf opendata.swiss zeigt die Breite des Angebots: nahezu 14’000 Datensätze, zahlreiche verantwortliche Stellen und vielfältige Anwendungen, vom Energie-Dashboard bis zu Mietpreisübersichten oder Abstimmungsanalysen. Diese Daten dienen oft nicht einfach als Ersatz für interne Daten oder Erhebungen, sondern als unabhängige Referenz, um Modelle zu kalibrieren, Analysen zu validieren und Ergebnisse korrekt einzuordnen. Durch ihren Entstehungsprozess im Rahmen von Verwaltungsprozessen sind sie teilweise sehr spezifisch, bilden aber für Regionen oder die ganze Schweiz meist die Gesamtsituation (im Sinne einer Vollerhebung) ab. Sie können so als Ground-Truth-Proxy genutzt werden und dazu beitragen, Insights aus anderen Quellen zu objektivieren und Verzerrungen zu reduzieren.

Entwicklungspotenzial mit Open by Default

Mit dem Bundesgesetz über den Einsatz elektronischer Mittel zur Erfüllung von Behördenaufgaben (EMBAG, Inkrafttreten 1. Januar 2024) und der dazugehörigen Digitalisierungsverordnung (DigiV, Inkrafttreten 1. Mai 2025) wurde die Bereitstellung offener, maschinenlesbarer Verwaltungsdaten durch die Bundesverwaltung im Sinne des Open by Default-Prinzips verbindlich verankert. Damit ist die Bereitstellung von OGD nicht nur eine Good Practice, sondern eine dezidierte Aufgabe, die das Angebot in den kommenden Jahren wachsen lassen wird. Ziel ist, dass OGD Innovationsfähigkeit, Transparenz und Effizienz der öffentlichen Verwaltung fördern, indem sie neue Formen der Zusammenarbeit zwischen Verwaltung, Wirtschaft und Forschung ermöglichen. Internationale Analysen (etwa der OECD) zeigen, dass offene Verwaltungsdaten ein wesentlicher Treiber für evidenzbasierte Politik, nachhaltige Verwaltungsleistungen und datengetriebene Marktinnovationen sein können. Die Schweiz verfolgt damit eine langfristige strategische Ausrichtung, in der hochwertige, interoperable und wiederverwendbare Daten als öffentliches Gut betrachtet werden. Unternehmen wie auch die Zivilgesellschaft und die Forschung sollen gleichermassen davon profitieren.

OGD und KI passen gut zusammen

Mit der wachsenden Verbreitung generativer KI in den letzten Jahren entstand kurz der Irrglaube, dass diese die Grundlagenarbeit an den Daten ersetzen könnte. Heute hingegen rückt die Frage nach belastbaren, neutralen und dauerhaft verfügbaren Daten ins Zentrum. Gute KI braucht gute Daten. OGD bieten hierfür eine wichtige Grundlage, da sie unabhängig erhoben, standardisiert dokumentiert und regelmässig aktualisiert werden. Mit dem wachsenden Angebot haben sie das Potenzial, als stabile und verlässliche Referenzpunkte für Trainings- und Validierungsprozesse zu dienen. Sie ermöglichen, Modelle gegen Vergleichswerte zu testen, Fehlerquellen früh zu erkennen und Verzerrungen zu minimieren. Zudem unterstützen sie agentische Systeme sowie RAG-Anwendungen, indem sie eine reproduzierbare Faktenbasis liefern. Dadurch entstehen nachvollziehbare, überprüfbare Insights, die direkt in Geschäftsprozesse einfliessen und die Qualität datenbasierter Entscheidungen verbessern.

Use Cases: Wie Unternehmen konkret profitieren können

Wie sich anlässlich des Swiss Insights Talks zum Thema «Potenziale & Herausforderungen von Open Data in der KI-gestützten Marktforschung» zeigte, ist das heutige Angebot an OGD noch nicht perfekt – die Schweiz bewegt sich mit ihrem Angebot im europäischen Mittelfeld. Aber wie Rolf Schenker von Statistik Stadt Zürich aufzeigte, können gute (linked) offene Daten der Verwaltung schon heute so durch LLMs genutzt werden, dass sie feine semantische Unterschiede erkennen und den Nutzenden auch die richtige Antwort liefern können. In einem gemeinsamen Beitrag der BSI Software AG und des BFS (Bundesamt für Statistik) konnten Christoph Bräunlich und ich zudem anhand eines von BSI erarbeiteten Prototypen zeigen, wie aus OGD in einem CRM-System ein konkreter Mehrwert entstehen kann. Beispielsweise, indem diese Systeme mit Kontextinformationen zu den Kund:innen angereichert werden. Vor allem aber, wie Agents für Banken und Versicherungen aus Geodaten spezifische, auf die Kund:innen zugeschnittene Angebote für Überschwemmungsschäden oder die Finanzierung von Solardächern automatisch generieren können.

OGD: Ein potenzieller Verstärker für KI und Insights

In einer zunehmend KI-geprägten Welt werden vertrauenswürdige Daten zur Währung der Wirklichkeit: Sie verhindern Verzerrungen, schaffen Orientierung und erhöhen die Zuverlässigkeit automatisierter Entscheidungen. Da OGD dabei allen und für alle Nutzungen frei zur Verfügung stehen, sind sie nicht per se eine Grundlage für einen Wettbewerbsvorteil und ebenso wenig ein billigerer Ersatz für interne Daten oder spezifische Erhebungen aus der Marktforschung. Sie können aber wichtige Verstärker sein, wenn sie durch datenkompetente Unternehmen gezielt eingesetzt werden. Die Kombination aus hochwertigen öffentlichen Daten und KI-Methoden, spezifischen Kompetenzen und Daten aus der Marktforschung oder generell der Generierung von massgeschneiderten Insights hat so das Potenzial, nachvollziehbare und robuste Insights sowie skalierbare Anwendungen mit operativem Mehrwert zu schaffen.

Samuel Schütz
Strategieberater Direktion, Beisitzer der GL, BFS
Vorstandsmitglied Swiss Insgiht

samuel.schuetz@bfs.admin.ch, +41 58 463 67 25

Samuel Schütz ist Politikwissenschaftler, hat Erfahrung mit der strategischen Entwicklung in datenintensiven Aufgaben der Verwaltung und arbeitet seit 2013 in verschiedenen Funktionen im Bundesamt für Statistik BFS. Als Strategieexperte bei der Direktion des BFS prägt er seit 2020 die Ausrichtung des Amtes mit.

Download Artikel
Swiss Insights News #26-1

Alle SWISS INSIGHTS News finden Sie hier: SWISS INSIGHTS NEWS

Swiss Insights TALK – Potenziale & Herausforderungen von Open Data in der KI-gestützten Marktforschung

Wie ermöglichen Verwaltungsdaten, Linked Open Data und KI neue Einsichten und Geschäftsmodelle?

Am 30. Oktober 2025 fand in Zürich ein weiterer spannender Swiss Insights TALK statt. Die zahlreichen Teilnehmenden setzten sich intensiv mit Impulsen, Diskussionen und konkreten Anwendungen rund um offene Verwaltungsdaten, KI‑Technologien und Marktforschung auseinander.

In vier Referaten wurden folgende Themen beleuchtet

Von OGD zum konkreten Nutzen: Wie verwaltet der öffentliche Sektor Daten, wie werden sie bereitgestellt und welchen wirtschaftlichen Nutzen lässt sich daraus generieren? (Impuls von Samuel Schütz, Bundesamt für Statistik, BFS)

Wenn offene Daten sprechen lernen: Der Einsatz von Linked Open Data (LOD) am Beispiel des Chatbots MeLODy zeigte Rolf Schenker von Statistik Stadt Zürich, wie semantisch verknüpfte Daten eine KI‑Anwendung ermöglichen.

Von Open Data zum Kundenkontakt: In einem Use‑Cases, zeigten Christoph Bräunlich, BSI und Samuel Schütz, BFS, wie AI‑Agents offene Daten mit internen CRM‑Systemen verbinden und so neue Business‑Modelle ermöglichen.

Heisse Eisen, offene Daten: Lukas Golder und Dr. Tobias Keller von gfs.bern zeiten mit Blick auf politische Abstimmungs‑ und Wahlforschung (z. B. durch gfs.bern), wo offene Daten genutzt und auch publiziert werden, und welche ethischen, rechtlichen und methodischen Herausforderungen damit verbunden sind.

Was steckt dahinter?

OGD bezeichnet die strukturierte, frei verfügbare Bereitstellung von Verwaltungsdaten. Dabei spielen technische Qualität (maschinenlesbar, standardisiert, offen lizenziert) sowie der einfache Zugang eine zentrale Rolle.

Daraus resultiert ein konkreter Nutzen

Mehr Klarheit durch Verknüpfung: Statt generischer Begriffe wie z.B. «Einwohner Zürich» werden eindeutige Konzepte eingesetzt.

  1. KI‑Anwendung wie MeLODy zeigen, wie Daten korrekt interpretiert, Quellen angegeben und Antworten präzise geliefert werden können.
  2. OGD wie z.B. OpenData.swiss erleichtern die Arbeit und ermöglichen präzisere Hochrechnungen, gleichzeitig steigt aber auch die Abhängigkeit und der Wettbewerbsdruck erhöht sich.
  3. Kombination von CRM, offenen Daten und AI‑Agents schafft skalierbare Geschäftsmodelle: externe Daten reichern interne Kundendaten an und ermöglichen personalisierten Dialog.

Chancen

  • Automatisierte Datenverarbeitung: Offene, gut strukturierte Daten reduzieren Aufwand und erhöhen Geschwindigkeit.
  • Zusätzliche Datenpunkte = mehr Genauigkeit: Durch die Einbeziehung externer Verwaltungsdaten lassen sich neue Erkenntnisse gewinnen.
  • Innovation durch Verknüpfung: LOD und KI eröffnen neue Wege, Daten für Marktforschung und Business‑Modelle zu nutzen.

Auf Folgendes sollte man achten

  • Abhängigkeit von einzelnen Datenquellen
  • Gefahr einer Monopolisierung trotz «Offenheit»
  • Fehler in Daten führen zu systematischen Folgefehlern
  • Ethische/ rechtliche Aspekte

Fazit

Die Veranstaltung zeigte eindrücklich, dass offene Verwaltungsdaten nicht nur „nice to have“ sind, sondern ein zentraler Treiber für datenbasierte Innovation sein können, vorausgesetzt, sie sind technisch, rechtlich und organisatorisch gut eingebettet.

Wir danken Referierenden Samuel Schütz, Rolf Schenker, Christoph Bräunlich, Lukas Golder und Dr. Tobias Keller für die lebendige Diskussion und den Austausch sowie Irina Brandenberger für die professionelle Moderation.

Danke an die Eventpartner

Ein herzlicher Dank geht an unsere Eventpartner. Sie leisten nicht nur einen wertvollen Beitrag zur Durchführung, sondern ermöglichen es auch, neue Themen aufzugreifen, aktuelle Entwicklungen zu reflektieren und gemeinsam den Blick über den Tellerrand hinaus zu richten.

gfs.bern, Bilendi, GIM Suisse AG, intervista ag Demoscope und smartinterviews

Präsentationen

  • Von OGD zum konkreten Nutzen: Wie die Verwaltung Daten öffnet und Innovation ermöglicht
    Samuel Schütz
    (Download Präsentation)
  • Wenn offene Daten sprechen lernen: Wie Linked Open Data den Chatbot MeLODy der Stadt Zürich ermöglicht
    Rolf Schenker
    (Download Präsentation)
  • Von Open Data zum Kundenkontakt: Wie öffentliche Daten und AI-Agents neue Business Cases ermöglichen
    Christoph Bräunlich, Samuel Schütz
    (Download Präsentation)
  • Heisse Eisen, offene Daten: Open Data in hitzigen Abstimmungsdebatten
    Lukas Golder, Dr. Tobias Keller
    (Download Präsentation)

Projekt statbot.swiss: Mehr als nur ein statistischer Bot

In welcher Schweizer Gemeinde ist der Anteil der Elektroautos am höchsten? Und welche Gemeinde hat die meisten Dieselfahrzeuge? Das Projekt statbot.swiss hat zum Ziel, die Machbarkeit eines Bots zu prüfen, der statistische Fragen eigenständig mittels KI beantworten kann.

Eine Bürgerin sucht nach Daten der öffentlichen Statistik in der Schweiz: Die Wahrscheinlichkeit ist hoch, dass damit eine digitale Odyssee beginnt, statt, dass die Suche nach einer kurzen Suchmaschinenanfrage endet. Denn selbst für erfahrene Recherchierende ist es nicht immer leicht, Daten zu finden: Befinden sich die gesuchten Daten vertikal auf Ebene Bund, Kantone oder Gemeinden? Und welche Behörde oder welches Amt stellt innerhalb einer Ebene die Daten bereit? Die Suchmaschinen haben Mühe, die gesuchten Informationen zu indizieren, da sie sich in verschiedenen Applikationen oder sogar Dokumenten befinden. So klicken sich die Bürger durch, bis sie die gewünschten Informationen erhalten – oder bis sie die zuständige Stelle gefunden haben, bei der sie ihre Anfrage platzieren können.

Machine learning to the rescue?

Können wir nicht einen Algorithmus trainieren, uns die richtigen Antworten auf unsere Fragen zu liefern? Ist es nicht genau das, was Google und Co. machen und nicht immer schaffen? Unsere Schlussfolgerung ist: Wenn die Daten nicht «richtig aufbereitet» sind, dann fehlen die Grundlagen für die Anwendung eines fortgeschrittenen Algorithmus.

Die benötigten Daten der Schweizer Behörden stehen qualitativ hochwertig zur Verfügung. Trotzdem ist es nahezu unmöglich, einen Algorithmus im Umgang mit diesen Daten so zu trainieren, dass er die Frage «was ist der Anteil der registrierten Elektroautos im Kanton Zürich» korrekt beantwortet.

Das seit längerer Zeit bekannte Problem von maschinell nicht lesbaren Datenformaten wie Excel oder PDF spielt dabei nur eine kleine Rolle. Vor allem fehlt es in der Schweiz an einheitlichen Ansätzen für Datenstrukturen; nicht nur zwischen den verschiedenen Datenproduzenten, sondern sogar innerhalb deren jeweiligen Datenportalen. Die Probleme sind:

  1. Qualität (wahr und nicht suggestiv)
  2. Ohne menschliches Zutun sind zeitliche Elemente, räumliche Elemente, Dimensionen und Attribute nicht identifizierbar.
  3. Die Daten sind uneinheitlich sowohl im «Long-Format» wie auch im «Wide-Format» –
  4. zusätzlich findet man manchmal sogar Kreuztabellen oder gar Listen.
  5. Es fehlt eine Standardisierung der verwendeten Codes und Labels.
  6. Die Definitionen der relevanten Daten sind nicht in jedem Fall harmonisiert – beispielsweise errechnen Bund, Kantone und Gemeinden die Bevölkerungszahlen der Stadt Zürich leicht unterschiedlich.
  7. Spalten gleicher Datenkategorien sind unterschiedlich benannt

Als Konsequenz dieser unterschiedlichen Datenstrukturen ist der Bau jeglicher datensatzübergreifenden Applikation mit beträchtlichem Aufwand verbunden – unabhängig davon, ob es sich um eine High End Machine-Learning-Lösung oder um ein simples Indikatorenportal handelt. Selbst wenn nur die Daten aus einem einzigen Datenportal eingelesen werden, kann die Menge der eingelesenen Datasets nicht beliebig vergrössert werden, da man für jedes Dataset einen separaten Code schreiben muss.

Standards and data harmonization to the rescue!

Hier setzen wir mit dem Projekt statbot.swiss an. Finanziert wird es durch eGov Schweiz, geleitet vom Bundesamt für Statistik und der Konferenz der regionalen statistischen Ämter der Schweiz. Technologische Partner sind die Zürcher Hochschule für angewandte Wissenschaften (ZHAW) sowie das Swiss Data Science Center (SDSC).

Das Projekt besteht aus zwei Teilen: Im chronologisch zweiten Teil experimentieren Forschende der Zürcher Hochschule für angewandte Wissenschaften an einem Machine-Learning-Algorithmus, der natürliche Sprache in Datenbankabfragen übersetzen kann [1]. Dieser soll die Antworten in Form von Datenwerten, Tabellen oder Grafiken anzeigen. Das aktuelle Projekt setzt dabei den Fokus absichtlich und bescheiden auf die Abklärung der Machbarkeit und der technischen Limitierungen.

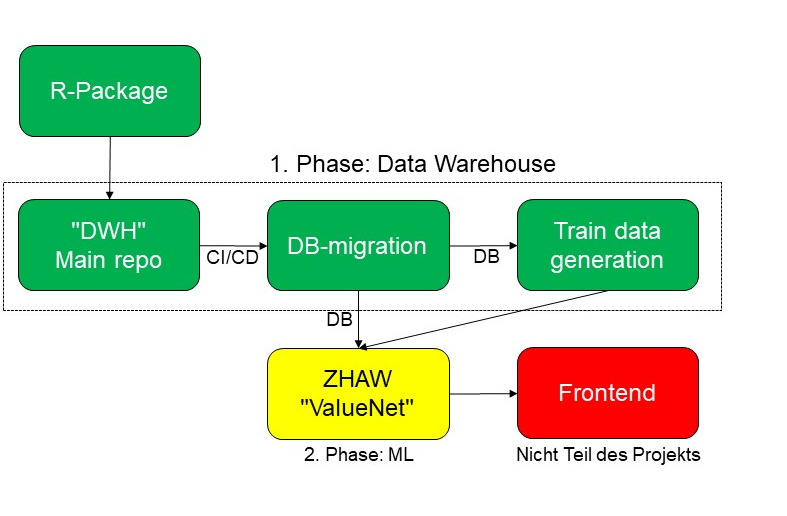
Im bereits abgeschlossenen ersten Teil des Projekts haben wir ein Open Source Data Warehouse [2] gebaut, das Daten aus unterschiedlichen Quellen an einem Ort integriert und harmonisiert. Es lädt die Daten aus unterschiedlichen Schnittstellen, führt die gesamte Transformation («ETL») aus und erstellt alle Daten in einer einheitlichen, definierten Datenstruktur mit dazugehörenden Mapping-Tabellen für Dimensionen. Ziel war auch, die Datenstandardisierung und -harmonisierung voranzubringen.

[1] Die ZHAW leitet das Projekt «INODE – Intelligent Open Data Exploration», das vom EU-Forschungsprogramm Horizon 2020 mit knapp 6 Millionen Euro gefördert wird.).

[2] https://renkulab.io/gitlab/christian.ruiz/statbot-swiss

Abbildung 1: Übersicht über die verschiedenen open source Repositories. Die Machine-Learning-Lösung der ZHAW wird dann sowohl auf die Datenbank, wie auch auf die generierten Trainingsdaten zugreifen. Ein sehr einfaches Frontend soll erstellt werden.

Das Hinzufügen der Daten ist dabei skalierbar: wir konnten Stand heute über 240 «Statbot-Datasets» mit Inputdaten sowohl aus dem Bundesamt für Statistik wie auch aus sechs weiteren regionalen Statistikämtern hinzufügen. Wir haben dabei einen Prozess geschaffen, der keine Programmierung durch Mitarbeitende von teilnehmenden Statistikämtern benötigt. Stattdessen brauchen diese nur das sprichwörtliche Rezept anzugeben, wie die Daten verarbeitet werden sollen: Für einen Milchshake müssen die Früchte gewaschen, geschält, dann in den Mixer gegeben und am Ende mit Milch gemischt werden. Die Reihenfolge dieser Schritte gibt der Mitarbeitende ein einziges Mal ein, dann kann die Maschine regelmässig die aktuellsten Inputdaten holen und die notwendigen Transformationen durchführen.

Wichtig ist dabei auch, dass dieser Endzustand aller Datasets gleich ist, wobei wir hier eine Lösung gefunden haben, die sich an bisherigen Ansätzen orientiert [3]. Als zusätzlicher Schritt müssen daher Dimensionen «harmonisiert» werden. Jede Dimension wie Geschlecht oder Staatsangehörigkeit hat dabei gewisse Codes. Wenn die Standardcodes (üblicherweise aus dem Bundesamt für Statistik) verwendet werden, läuft das Matching ohne grösseren Zusatzaufwand. Ansonsten können neue Mappings hinzugefügt werden, um eine flexible Zuordnung herzustellen.

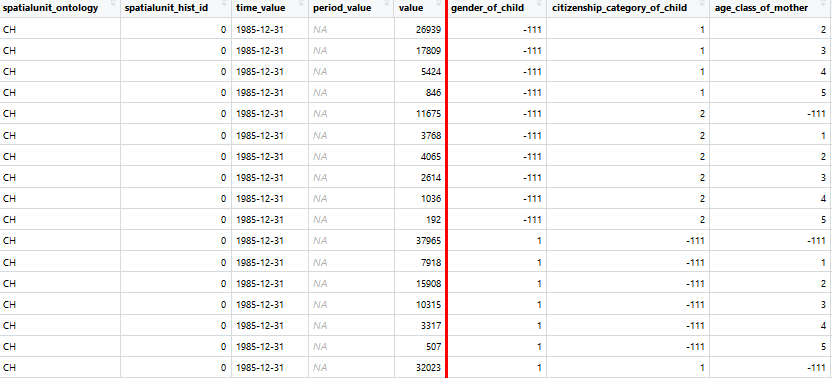
Das Resultat sind relationale Daten in einer definierten Struktur mit einheitlichen Spaltenbezeichnungen, Zuordnung von Raum, Zeit, Dimensionen sowie Attributen und klar bestimmten Kodierungen [4].

Diese «Statbot-Datasets» sind somit einheitlich strukturiert. Damit ist es leichter, daraus datensatzübergreifende Applikationen zu bauen, beispielsweise eine Machine-Learning-Lösung wie im zweiten Teil des Projekts oder ganz andere Applikationen, die nun auf solche bereinigten Daten zugreifen könnten.

[3] Es orientiert sich sowohl an der Linked Data Lösung von Statistik Stadt Zürich wie auch am SDMX-Format, welches u.a. von Eurostat verwendet wird. Die Überlegungen gehen dabei noch weiter, ob sogar diese Formate generiert werden könnten.

[4] Momentan fehlt eine Vorgabe für eine «definierte Struktur» von Statistikdaten in Schweizer Statistikämtern. Diese funktionale Vorgangsweise könnte auch als Bottom-up-Lösung dienen, um einer Harmonisierung schrittweise näher zu kommen.

Abbildung 2: Ein Beispiel der definierten Datenstruktur eines «Statbot-Datasets». Die ersten beiden Spalten definieren eindeutig die Raumeinheiten. Die nächsten beiden Spalten definieren Zeitelemente (Stichtage sowie Perioden). Danach kommt der Beobachtungswert des Datenpunkts. Alles was rechts der eingezeichneten Linie ist, sind Dimensionen, die von Dataset zu Dataset unterschiedlich sind aber die in Dimensionstabellen definiert sind. Im Bild nicht sichtbar sind angedachte Attributsspalten: Quellenangaben, Definitionsangaben und «Flags» mit weiteren Informationen pro Datenpunkt.

Weiteres Potenzial

Das Projekt lehrt uns viel über Machine Learning. In Machine-Learning-Projekten geht es um weit mehr als den Gebrauch der Algorithmen. Viel Arbeit muss in Grundlagenarbeit gesteckt werden, um die Daten für Algorithmen überhaupt brauchbar zu machen. Dazu gehört auch die Bereitstellung von «Trainingsdaten», also Paare von Fragen in natürlicher Sprache und passenden Antworten in Form von Datenbankabfragen. Die werden dann verwendet, um den Algorithmus zu trainieren. Hier haben wir mit zusätzlichen Sprachinformationen gearbeitet, um sinnvollere Sätze zu generieren, die aber dennoch etwas hölzern erscheinen.

Die klare Trennung von Inhalt und Bezeichnung und die einheitliche Strukturierung und Harmonisierung der Bezeichnungen im Data Warehouse werden es darüber hinaus erlauben, automatisiert hochwertige «Linked Open Data» zu generieren. Linked Open Data sind Daten, die schnittstellenartig per HTTP abgerufen werden können, und die auf weitere Ressourcen verweisen können.

Dies würde vernetzte Datenlösungen ermöglichen, welche Daten aus den verschiedensten Quellen kombinieren könnten und es würde ein semantischer Datenraum geschaffen werden. Das wäre ein zusätzlicher Mehrwert für Nutzende, Firmen sowie das gesamte Statistiksystem der Schweiz, da es weitere maschinelle Anwendungen ermöglichen würde.

Ein Projekt-Teilnehmer hat kürzlich Folgendes treffend formuliert: «Auch nach dem offiziellen Ende des Projekts statbot.swiss glaube ich, dass das Data Warehouse bestehen bleiben wird… Es ist womöglich das erste Mal in der Schweiz, dass öffentliche Daten von verschiedenen Datenproduzenten an einem Ort in einer gemeinsamen, harmonisierten Struktur vorhanden sind.». Die Datenbedürfnisse der potentiellen Machine-Learning-Anwendung haben somit als wesentliche Anforderung dazu geführt, Daten zu strukturieren und zu harmonisieren. Dieses Resultat – das Data Warehouse – könnte viel Potenzial für andere Anwendungen haben.

Ich erinnere an dieser Stelle zunächst an die Bürgerin, die hoffentlich in der Zwischenzeit die gesuchten Daten gefunden hat. Jede Entwicklung, egal ob ein Data Warehouse, ein Bot oder eine andere Anwendung, muss direkt oder indirekt auf die Bedürfnisse der Bürger ausgerichtet sein. Öffentliche Behördendaten sollten einfacher auffindbar, vernetzter und leichter in andere Applikationen integrierbar werden.

Hier möchten wir mit der Community durch persönliche Gespräche, Events und Online stärker ins Gespräch kommen. Einerseits möchten wir die Datenbedürfnisse der Nutzenden besser kennen, um darauf bedarfsorientiert entwickeln zu können. Andererseits können wir damit leichter Lösungen wie den Bot in einer frühen Phase testen und Feedback integrieren. Wenn Sie Interesse haben, können Sie mir gerne formlos eine E-Mail mit Betreff statbot.swiss schreiben.

Dr. Christian Ruiz

Projektleiter Machine Learning
Statistisches Amt Kanton Zürich

christian.ruiz@statistik.ji.zh.ch
+41 43 259 75 12

Der Autor
Dr. Christian Ruiz leitet aktuell das Machine Learning im Statistischen Amt Kanton Zürich. Er hat 13 Jahre Erfahrung in Data Science und 6 Jahre Erfahrung in der praktischen Entwicklung von Machine-Learning-Anwendungen. Er ist Mitgründer von zwei Startups im Bereich Deep Learning, hat drei weitere Machine-Learning-Projekte umgesetzt und andere Projekte begleitet.

Download Artikel
Swiss Insights News #12

Alle SWISS INSIGHTS News finden Sie hier: SWISS INSIGHTS NEWS